 Latency, ofwel de voice-to-voice-vertraging tussen het moment dat een beller uitgesproken is en het moment dat de bot begint te praten, bepaalt in veel gevallen of een gesprek met een voicebot wel of niet natuurlijk aanvoelt. In dit kennisartikel leggen we twee architecturen naast elkaar: de directe speech-to-speech-aanpak (S2S) en de klassieke cascade van speech-to-text, taalmodel en text-to-speech.
Latency in een conversatie tussen klant en voicebot hoeft niet altijd problematisch te zijn. In een gangbaar fysiek gesprek tussen mensen omvat de beurtwisseling tussen twee sprekers een overgangstijd van gemiddeld 200 milliseconden. Voor het Nederlands is dat gemiddelde vaak nog iets korter. Als een van de beide sprekers tijdens een fysiek gesprek feedback krijgt of uit de context kan afleiden dat een antwoord wat langer op zich laat wachten, wordt dat doorgaans niet als problematisch ervaren. De gemiddelde duur van een beurtwisseling verschilt per land. 200 milliseconden wordt vaak genoemd als norm voor de tijd bij een beurtwisseling in een acceptabel verlopend gesprek, maar in de praktijk hangt de perceptie van latency af van veel factoren. Zelfs binnen een gesprek kunnen verschillende vormen van vertraging wel of niet acceptabel zijn.
Situatieafhankelijk
Een wat langere latency is bijvoorbeeld geen probleem als een voicebot iets moet opzoeken in een systeem (en dat eventueel laat weten). Dat is iets wat klantcontactmedewerkers in de praktijk ook regelmatig doen. De impact van latency is met andere woorden situatieafhankelijk. Maar dat kan je pas beoordelen als je weet wat er precies gemeten is, bij hoeveel gelijktijdige gesprekken en over welk deel van de verwerkingsketen.
Die situatieafhankelijkheid geldt ook voor de voor- en nadelen van de twee gangbare architecturen: het cascade-model en het speech-to-speech-model. Geen van beide is ‘de beste oplossing’ en je kunt er zelfs voor kiezen om beide benaderingen naast elkaar te gebruiken.
Het cascade- of pipeline model
De klassieke aanpak wordt ook wel aangeduid als de cascade of gecascadeerde pipeline. In deze architectuur worden steeds opnieuw verschillende tussenstappen gezet.
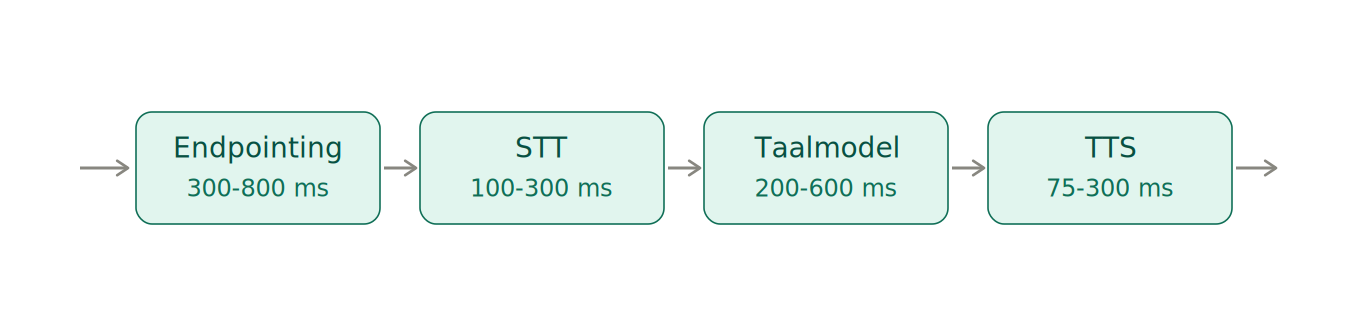
Eerst moet de bot bepalen of de spreker is uitgesproken. Bij groen licht zet speech-to-text (STT) de spraak van de beller om in tekst. Die tekst gaat naar een taalmodel (LLM) dat vervolgens bepaalt wat de bot als antwoord moet gaan geven. Wanneer dat nodig is, haalt de bot daarbij informatie op uit een kennisbank, een CRM-applicatie of een RAG-koppeling of een combinatie daarvan. Als het antwoord in tekst is geformuleerd, zet text-to-speech (TTS) dat antwoord weer om in spraak. Elke stap uit deze modellen kan gebruikmaken van streaming, waarbij de verwerking plaatsvindt terwijl de beller nog praat.
Van beurt wisselen
Endpointing is het moment dat de bot aanwijst als punt waarop de beller is uitgesproken. Daarvoor wordt, naast een vast ingestelde wachttijd, gebruikgemaakt van een akoestische meting door een voice activity detector (VAD). Het zo strak mogelijk afstellen van dit beurtwisselingsproces kan veel tijdwinst opleveren in een dialoog met een voicebot. Maar te strakke instellingen kunnen ervoor zorgen dat de beurtwisseling niet goed verloopt omdat dat de bot begint te antwoorden terwijl de beller nog niet klaar is. Er zijn oplossingen die de beurtwissel ook baseren op een semantische analyse – dus op basis van woordkeuze, zinsbouw en intonatie – om zo de effectiviteit te vergroten.
Elke stap kan uitgevoerd worden met verschillende oplossingen die elk hun eigen verwerkingstijd kennen. Voor die verwerkingstijden zijn per technologie benchmarks beschikbaar; maar wat vandaag geldt, kan morgen achterhaald zijn omdat achterliggende technologie is verbeterd. Daarnaast is er bij vrijwel elke verwerkingsstap tijd nodig voor data-uitwisseling van de ene naar de andere technologie, die afhangt van de kwaliteit van het netwerk en de verbindingen.
Door streaming overlappen de stappen, waardoor de som hoger uitvalt dan de werkelijkheid, terwijl de endpointing-wachttijd en de verwerkingstijd in het netwerk er juist bovenop komen.
De invloed van netwerkverbindingen op latency – Contactcenters die gebruikmaken van een WebRTC-verbinding, beschikken daarbij over een voice- en datakanaal, waarbij die verbinding permanent open staat. In het datakanaal kan klantinformatie (bijvoorbeeld een nummer of tekst) worden meegestuurd. Bij WebRTC speelt verder de kwaliteit van de wifi, de browser, de microfoon en het netwerk van de klant mee.
Bij een zogenaamde PSTN-call (het publieke telefoonnetwerk) bestaan die nadelen ook en kan daarnaast naast audio alleen informatie over het nummer (CLI) worden doorgegeven en verder niets. In het transport van informatie over zo’n PSTN-lijn spelen bovendien vertragingsfactoren mee zoals jitter en omzettingssnelheid (van analoog naar digitaal).
Het voordeel van de verschillende omzettingsslagen in het cascademodel is dat er standaard een transcript beschikbaar is van de dialoog. Dat kan gebruikt worden voor analysedoeleinden en voor compliance-toepassingen. Het LLM is ook de plek waar andere tekstgebaseerde zaken als business rules, guardrails en een RAG kunnen worden ingericht.
Het speech-to-speech model (S2S)
Het tweede architectuurmodel is speech-to-speech. Daarbij is er één oplossing die de spraak verwerkt en tegelijkertijd een reactie geeft, zonder dat de omzetting naar tekst noodzakelijk is. Minder omzettingen betekent minder verwerkingstijd en dat verschil is merkbaar in de praktijk. Het meest bekend is OpenAI Realtime API met de modelgeneraties gpt-realtime-2 en gpt-realtime-2.1. De oplossing van OpenAI ondersteunt ook SIP. Het model van Moshi komt volgens de makers uit op ongeveer 200 milliseconden, gemeten op één GPU in een testopstelling. Dat is een modelwaarde en geen contactcenterwaarde. Omdat Moshi full-duplex werkt, zit er geen endpointing-wachttijd in, wat een deel van het verschil met de cascade verklaart.
Verder is niet meegerekend: de zoektijd in CRM-systemen of RAG-oplossingen via API-calls die nodig zijn voor complexere kwesties, en de vertraging afkomstig uit het netwerk en de telefonieketen. In de praktijk komen S2S-modellen uit op verschillende waarden tot ongeveer 800 milliseconden (peildatum 2026); de waarden kunnen variëren door verschillende factoren. De waarden kunnen bovendien over de volle breedte afnemen door technologie die in de loop van de tijd beter wordt.
Speech-to-speech-modellen zijn full-duplex, wat betekent dat de beller de voicebot kan onderbreken (barge-in) en dat de bot – omdat deze luistert tijdens de verwerking – hier ook effectief op kan reageren. Speech-to-speech werkt primair op basis van audio-tokens. S2S-oplossingen zijn getraind op basis van miljoenen uren aan audiomateriaal – denk aan vergaderingen, films en nieuwsuitzendingen. Een beperking is dat deze collecties niet tot nauwelijks klantenservice-gesprekken bevatten; in sommige sets zijn telefoongesprekken, gewone en synthetische gesprekken aan het trainingsmateriaal toegevoegd. Een voorbeeld van zo’n trainingsset staat op HuggingFace.
Audio als trainingsmateriaal betekent ook dat S2S-modellen ‘begrip’ hebben van verbale eigenschappen van spraak: intonatie, toonhoogte, volume, snelheid. Hiermee kunnen speech-modellen gebruikmaken van informatie over emoties en effectief reageren op de prosodie (klemtonen, toonhoogte, ritme en tempo). Maar die informatie wordt in spraakmodellen niet apart gelabeld of gelogd – ‘klant is boos’ vind je dus nergens terug.
Een andere tekortkoming van S2S-modellen is dat ze de prosodie van de klant kunnen overnemen. Dat draagt niet bij aan een effectief verlopend gesprek; als een klant sneller en harder gaat praten vanwege toenemende boosheid, is het juist niet de bedoeling dat de voicebot die communicatiestijl overneemt.
De kwaliteiten op dit vlak beperken zich verder tot de meest gesproken talen. Naarmate talen kleiner zijn, neemt de kwaliteit van de technologie af. Voor wie met klanten uit verschillende landen of taalgebieden werkt, is dit een punt van aandacht.
Transcript
Bij S2S is een transcript niet noodzakelijk voor de werking van de voicebot. Zo’n transcript is voor veel contactcenters juist essentieel voor compliance- en analyse-doeleinden. Bij sommige oplossingen komt het transcript vanuit een tweede model dat parallel meeluistert. Dat is bruikbaar voor zoeken, dashboards en steekproeven, maar niet bruikbaar als bewijsstuk voor wat de bot heeft gehoord of (toe)gezegd. Omdat het tweede model de audio apart verwerkt, los van het spraakmodel, kan de uitkomst afwijken van wat de voicebot daadwerkelijk heeft gehoord, met verkeerde woorden, soms zelfs de verkeerde taal, en een vertraging van enkele seconden.
Het model van Moshi werkt anders en genereert een transcriptie waarbij de tekst uit hetzelfde model voortkomt als de audio. Wie met S2S aan de slag gaat, heeft ruime keuze maar moet ook kijken naar de kosten voor tokens en opslag.
Je kunt er ook voor kiezen om alsnog een cascademodel of een aparte ASR-oplossing laten meedraaien; de voicebot-constellatie draait dan op twee architecturen tegelijk.
Zolang transcriptie alleen meeloopt voor logging kost het geen tijd, maar zodra het de basis vormt voor guardrails die het gesprek moeten kunnen stoppen, bestaat de kans dat je de latencywinst van S2S weer inlevert.
Omgekeerd geldt ook: wie tijdens het gesprek het sentiment wil monitoren bij gebruik van het cascade-model, moet andere technologie realtime laten ‘meeluisteren’. In dit verband zijn de AVG en de AI Act relevant. Uit spraak afgeleide emotie is een persoonsgegeven zodra je het vastlegt, en dan gelden bewaartermijn en grondslag.
Latency maskeren
Er zijn verschillende technieken om latency te overbruggen. Veelgebruikte oplossingen zijn het laten horen van de ademhaling van de ‘medewerker’, het laten horen van toetsenbordgeluiden, het letterlijk vertellen dat er iets wordt opgezocht en dat dat even duurt, filler-zinnen en tussenwerpsels of alvast beginnen met de eerste zin van het antwoord. Overigens is het toevoegen van menselijke geluiden discutabel, omdat daarmee de indruk wordt gewekt dat er sprake is van een menselijke medewerker, iets wat haaks staat op de transparantieverplichting uit de AI Act.
Kosten
Beide modellen werken met technologie die zich snel ontwikkelt. Dat geldt ook voor de kosten: in beide gevallen zijn die onvoorspelbaar over een wat langere termijn. Indicaties zijn 0,25 tot 0,35 dollar per gespreksminuut voor S2S-oplossingen; 0,10 dollar per minuut of minder voor cascade-oplossingen (peildatum 2026). Daarbij kan het per tariefmodel verschillen wat wel en niet is inbegrepen.
Waar moet je op letten bij latency-opgaven?
Wie wil weten wat de latency van een oplossing is, moet niet kijken naar demo’s. Er zijn drie zaken om rekening mee te houden.
1. Vraag allereerst naar de voice-to-voice-waarde en niet naar deelwaarden van latency. Het gaat om de tijd tussen het moment dat de beller ophoudt met praten en het moment dat de eerste inhoudelijke reactie van de voicebot te horen is. Dat is de waarde die alle vertragingsbronnen bevat. Leveranciers noemen in de praktijk vaak de verwerkingstijd van het model zelf of de tijd tot het eerste token, en die tijden vallen al snel een factor twee tot drie gunstiger uit dan wat de beller daadwerkelijk aan stilte ervaart.
2. Vraag daarbij niet naar het gemiddelde, maar naar de p50- en de p95-waarden. De P staat voor percentiel, ook bekend van bijvoorbeeld service level-rapportages. De p50-waarde is de mediaan, waarbij de ene helft van de beurtwissels sneller gaat en de andere helft langzamer. De p50-waarde bepaalt hoe natuurlijk een gesprek aanvoelt. De p95-waarde is de waarde waar 95 procent van de beurten onder blijft.
Voorbeeld: stel dat je voicebot op een dag duizend gesprekken voert, met elk zo’n twaalf beurtwisselingen. Bij een p50 van 0,6 seconde en een p95 van 2,4 seconde is het gemiddelde over die twaalfduizend beurten ongeveer 0,85 seconde. Op papier blijf je dus ruim onder de seconde, maar op die dag valt er zeshonderd keer een stilte van meer dan twee seconden. Die zeshonderd trage beurtwisselingen zijn verspreid over alle gesprekken, dus bij twaalf beurtwisselingen per gesprek maakt ongeveer de helft van duizend klanten zo’n vertraging minimaal één keer mee. Bij dat soort vertragingen kan een beller denken dat de verbinding verbroken is. Bepalend daarbij is ook het soort gesprek en het moment in het gesprek en met welke middelen die vertraging eventueel wordt opgevuld (het eerder genoemde ‘maskeren’).
3. Vraag om cijfers gebaseerd op bestaande productieomgevingen met een referentieklant. Een demo gaat om één sessie, met een optimale infrastructuur en een endpoint dichtbij. In productie spelen alle variabelen een realistische rol: wachtrijen, gelijktijdige gesprekken, endpointing die vertraagd is door accenten, achtergrondgeluiden of een mobiele verbinding of API-calls die meer tijd kosten dan verwacht.
De keuze gaat uiteindelijk niet over de architectuur maar over de vraag welk gesprekstype welke vertraging verdraagt en wat je klanten bereid zijn te accepteren.
(Ziptone/redactie)


Ook interessant
-

Volgens OpenAI is GPT‑Realtime ontwikkeld met oog op gebruik in onder meer klantenservice. Er is nog geen informatie over de…
-
Speech-to-speech werkt sneller dan het 'traditionele' voicebot-model. Robin van Leyden van Steam-connect geeft tekst en uitleg.
-

GPT-Realtime-Translate van OpenAI kan gesprekken live vertalen terwijl iemand praat, zonder merkbare vertraging, aldus het bedrijf.